Introduzione
Sempre più spesso durante lo sviluppo di piattaforme software, soprattutto quando sono di dimensione medio/grande e vedono il coinvolgimento di più sviluppatori, risulta essere necessaria l’adozione di strumenti che mirino a rendere più rapidi ed efficienti tutti i processi che vanno dalla progettazione fino al deploy in produzione.
In questa ottica è raro oramai trovare qualche software house che non si avvalga di strumenti di versioning e condivisione del codice, quali ad esempio GIT, mentre non tutti hanno adottato delle procedure, più o meno automatizzate, che permettano di integrare i diversi sviluppi in maniera efficiente. Certo, qualora lo sviluppo avvenga a regola d’arte, anche l’integrazione di corposi blocchi applicativi non dovrebbe avvenire senza grosse difficoltà, ma l’esperienza ci insegna che, soprattutto al crescere di dimensione e complessità, è conveniente effettuare l’integrazione di unità più piccole.
Questa è una delle indicazioni fornite dalla Continuous Integration (CI): allineare in maniera costante, anche più volte al giorno, la mainline (o comunque l’ambiente condiviso) con il lavoro negli ambienti degli sviluppatori del progetto. Effettuare queste operazioni manualmente richiede, però, un dispendio di effort che aumenta con l’aumentare del numero di integrazioni; per questo motivo molti sviluppatori hanno iniziato con lo sviluppare script custom che cerchino di automatizzare quanto più è possibile queste operazioni. Il proliferare di questi script, la necessaria configurazione per ciascuno degli sviluppatori nonché la complessità che possono raggiungere all’aumentare dell’automatismo richiesto, ha fatto nascere nel tempo una serie di strumenti di CI quali ad esempio Jenkins, Travis CI, Circle CI o GitLab CI.
Quest’ultima soluzione, visto che è già integrata nella piattaforma GitLab, ci permette di utilizzare il nostro strumento di versioning del codice e contemporaneamente iniziare ad avvicinarci al mondo della Continuous Integration, fornendo quindi a tutti i componenti del team degli strumenti per un’integrazione più rapida del codice nonchè una verifica dello stesso per individuare immediatamente dei malfunzionamenti.
Pipeline CI in GitLab
GitLab utilizza il concetto di Pipeline per la definizione delle operazioni da compiere nella procedura automatica di CI (anche in quelle di Continuous Development, ma non rientra nello scopo dell’articolo). Una Pipeline (tubatura) è un insieme di elementi collegati tra loro in modo che l’output di ciascun elemento (o di più elementi) sia l’input del successivo (o dei successivi). Nel caso specifico ciascuno degli elementi della Pipeline viene chiamato Job e viene eseguito da un Runner; qualora uno dei Job andasse in errore GitLab interromperebbe l’operazione di integrazione e mostrerebbe allo sviluppatore un apposito messaggio. Senza voler confondere le idee, ma per dare un’indicazione anche delle potenzialità della piattaforma, di default i Job vengono eseguiti uno di seguito all’altro; qualora si vogliano eseguire più Job in parallelo, questi possono essere raggruppati in Stages.
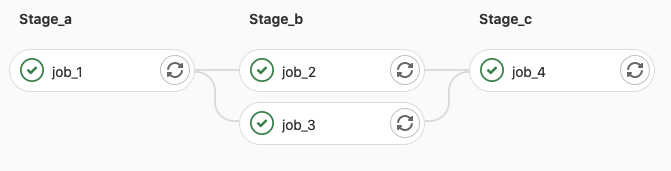
Configurazione
A questo punto il nostro ambiente è (quasi) pronto e possiamo passare alla configurazione della nostra Pipeline. All’interno del nostro progetto Angular è necessario creare il file .gitlab-ci.yml nella directory principale del nostro progetto. Quando si andrà ad effettuare il push, GitLab, trovando questo file, abiliterà automaticamente le funzionalità relative alla Pipeline, andando quindi a creare gli stages e, per ciascuno di essi, le relative operazioni da effettuare in essi.
Andiamo a vedere un esempio di file di configurazione, andando ad analizzarlo almeno nelle componenti di base.
services:
  - docker:dind

stages:
  - dependencies
  - test
  - build
  - publish

install_dependencies:
  image: node:12-alpine
  stage: dependencies
  script:
    - npm install
  rules:
    - if: $CI_COMMIT_TAG
       when: never
    - if: $CI_COMMIT_BRANCH == 'master'
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules

lint:
  image: node:12-alpine
  stage: test
  script:
    - npm link @angular/cli@11.2.6
    - ng lint
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull

test:
  image: markhobson/node-chrome:latest
  stage: test
  script:
    - npm link @angular/cli@11.2.6
    - npm test -- --browsers=ChromeHeadless --watch=false
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull

build_image:
  image: node:12-alpine
  stage: build
  script:
    - npm link @angular/cli@11.2.6
    - npm run build
  artifacts:
    paths:
      - $CI_PROJECT_DIR/dist
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull

push-gitlab-docker-registry:
  image: docker:latest
  stage: publish
  rules:
    - if: $CI_COMMIT_TAG
       when: never
    - if: $CI_COMMIT_BRANCH == 'master'
  script:
    - docker build -t test/angular-cicd-app .
    - docker push test/angular-cicd-app

push-docker-registry:
  image: docker:latest
  stage: publish
  rules:
    - if: $CI_COMMIT_TAG
       when: never
    - if: $CI_COMMIT_BRANCH == 'master'
  script:
    - docker build -t test/angular-cicd-app .
    - docker push javatodev/angular-ci-cd-app
In questo articolo di base non voglio analizzare a fondo le potenzialità del blocco relativo ai services per i quali, al momento, è sufficiente sapere che sono dei container aggiuntivi che saranno resi disponibili ai container dei diversi stages.
Definizione degli stages
Immediatamente dopo la definizione degli eventuali services troviamo la sezione stages nella quale vengono dichiarati gli stage della pipeline. Nel nostro esempio troviamo quindi le righe:
stages:
  - dependencies
  - test
  - build
  - publish
in cui vengono definiti 4 stages:
- dependencies: lo stage in cui verranno costruite le dipendenze necessarie alle operazioni successive
- test: lo stage in cui verrano lanciate le istruzioni per testare il codice
- build: lo stage in cui verrà effettuata la build della nostra applicazione
- publish: infine, lo stage in cui la nostra applicazione verrà pubblicata
Chiaramente non è obbligatoria una struttura di questo tipo ma, dal punto di vista logico, è plausibile avere questa suddivisione.
Definizione dei Jobs
I Jobs sono gli elementi principali di una pipeline ed eseguono delle operazioni; infatti è necessario che per ciascuno dei job inseriti all’interno della pipeline sia inserita una clausola script. All’interno delle definizione di un job possono esserci informazioni aggiuntive quali lo stage in cui deve essere eseguito e le condizioni che devono essere verificate affinché il job possa essere lanciato.
Nel codice seguente vediamo il primo dei job inseriti all’interno della pipeline di esempio che stiamo considerando.
install_dependencies:
  image: node:12-alpine
  stage: dependencies
  script:
    - npm install
  rules:
    - if: $CI_COMMIT_TAG
       when: never
    - if: $CI_COMMIT_BRANCH == 'master'
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
Ogni job deve avere un nome univoco, nel caso in esempio install_dependencies. Vediamo poi che viene indicata l’immagine del container in cui verrà eseguito il job, node:12-alpine, lo stage in cui essere eseguito, dependencies, e lo script che deve essere eseguito, npm install.
Nell’esempio sono riportate altre due informazioni: rules e cache. La prima consente di definire quando un job deve o non deve essere inserito all’interno di una pipeline. La seconda serve per individuare una serie di files o cartelle che devono essere mantenute nella cache tra i job [anche eventualmente appartenenti a pipeline differenti, ma non è oggetto del presente articolo]. Nel caso in esame viene inserita nella cache l’intera cartella node_modules; nella definizione della cache viene indicata una chiave univoca inserita nella clausola key, e nel caso specifico viene creata una nuova versione quando il file package-lock.json viene modificato.
Jobs di test
Dopo aver effettuato la costruzione delle dipendenze, nella nostra pipeline vengono eseguiti i job appartenenti allo stage di test. Questi due job eseguono il controllo lint del codice sorgente, per evidenziare errori di programmazione, bug, errori stilistici e costrutti sospetti, e gli unti test. Senza entrare nei dettagli delle operazioni dei due job, ciò che è interessante è l’utilizzo dei node_modules conservati nella cache, generati dal job nello stage relativo alla costruzione delle dipendenze.
lint:
  image: node:12-alpine
  stage: test
  script:
    - npm link @angular/cli@11.2.6
    - ng lint
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull

test:
  image: markhobson/node-chrome:latest
  stage: test
  script:
    - npm link @angular/cli@11.2.6
    - npm test -- --browsers=ChromeHeadless --watch=false
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull
Stage di build
Il job eseguito all’interno di questo stage si occupa di eseguire la build dell’applicativo e di definire un artifact per l’esecuzione corrente della pipeline.
build_image:
  image: node:12-alpine
  stage: build
  script:
    - npm link @angular/cli@11.2.6
    - npm run build
  artifacts:
    paths:
      - $CI_PROJECT_DIR/dist
  cache:
    key:
      files:
        - package-lock.json
    paths:
      - node_modules
    policy: pull
La configurazione artifacts prende tutto il contenuto della cartella dist e lo salva tra gli artifact dell’esecuzione dei job; essi sono resi disponibili tra i download nell’interfaccia grafica di Gitlab e sono automaticamente scaricati dai job successivi della pipeline utilizzando il meccanismo delle dipendenze.
Stage di publish
Non voglio entrare nei dettagli delle operazioni eseguite all’interno dei due job riportati nello stage di publish, ma volevo mettere in evidenza come, attraverso la pipeline, è possibile eseguire, ad esempio, la build di un’immagine docker per l’esecuzione della nostra applicazione Angular e il caricamento nel repository. E’ possibile utilizzare altri meccanismi di pubblicazione quali, ad esempio, il trasferimento sul server del codice contenuto nella cartella dist, o altre operazioni più o meno complesse.
Come esperienza personale ho avuto bisogno di kaniko per effettuare la build di un’immagine docker all’interno di kubernetes, ma eventualmente proverò in futuro a scrivere un articolo specifico!
Conclusioni
Nell’articolo abbiamo analizzato i motivi che portano oggi sempre più aziende ad investire nella CI/CD e abbiamo visto come strumenti quali Gitlab riescano a venire incontro a molte esigenze dei DevOps. Abbiamo visto anche un caso di esempio di pipeline andando ad analizzare alcuni dei componenti fondamentali per la definizione e l’esecuzione in Gitlab. Per maggiori approfondimenti si può utilizzare la documentazione ufficiale veramente molto esaustiva; al seguente link potrete trovare le keyword che possono essere utilizzate all’interno del file .gitlab.ci.yml